Les répondants synthétiques sont-ils fiables ? Nos chiffres, huit marchés
Les fournisseurs annoncent 85 à 95 % de précision. Nous publions un autre chiffre : à quel point des répondants simulés sont en désaccord entre eux, mesuré face aux enquêtes nationales de huit marchés, et les quatre choses qu’il ne prouve pas encore.
Les répondants synthétiques sont assez fiables pour classer et trier des idées, pas encore assez pour remplacer le terrain. Les 85 à 95 % de précision annoncés comparent des moyennes, ce qui est la partie facile. Mesurée face aux enquêtes nationales de huit marchés, la dispersion de nos répondants simulés allait de 0,20 à 0,76 de la dispersion humaine avant correction, et de 0,85 à 1,07 après.
L’essentiel
- Précision et fiabilité sont deux mesures différentes. La précision compare des moyennes. La dispersion compare le désaccord. Un panel peut être parfait sur la première et faux sur la seconde.
- La sous-dispersion est le défaut que presque personne ne publie. Avant correction : 0,20 à 0,76 de la dispersion humaine sur huit marchés. Après : 0,96 à 1,07 sur les attitudes et 0,85 à 1,00 sur la personnalité.
- Elle laisse toutes les moyennes justes. Elle fausse la comparaison entre options, pas le niveau de chacune, et c’est pour cela qu’elle passe inaperçue.
- Les chiffres sont mesurés face à des enquêtes publiques nommées, jamais face à un modèle.
- C’est une calibration, pas encore une validation hors échantillon.
Qu’est-ce qu’un répondant synthétique, et que veut dire « fiable » ?
Un répondant synthétique est l’ensemble des réponses qu’un modèle de langage produit quand on lui donne un persona : un briefing qui décrit qui répond, construit à partir de données réelles de population. Ce n’est pas la simulation d’une personne. C’est un objet statistique, qui ne vaut que par l’accord entre la distribution des réponses qu’il produit et celle que donneraient de vraies personnes.
« Fiable » a donc deux sens. Le premier : la moyenne simulée est-elle proche de la moyenne humaine ? Le second, qui compte dès qu’on compare des options : les répondants simulés de même profil sont-ils aussi partagés que les vrais ? Presque tous les chiffres publiés répondent au premier. Le nôtre répond au second.
Pourquoi la précision n’est-elle pas la bonne première question ?
Parce qu’elle se calcule sur des questions dont on connaît déjà la réponse, et qu’elle compare des moyennes. Or un test de concept, un pré-test publicitaire ou une optimisation se lisent sur des écarts entre options. Ces écarts dépendent de la dispersion. Un panel trop homogène rapproche artificiellement deux options que le terrain sépare nettement, et en éloigne deux qui se valent.
Nous l’avons résumé dans notre chronique du Journal du Net : quand des répondants sont unanimes, l’unanimité elle-même est un signal d’alerte.
Les répondants synthétiques sont-ils fiables ? Huit marchés, avant et après
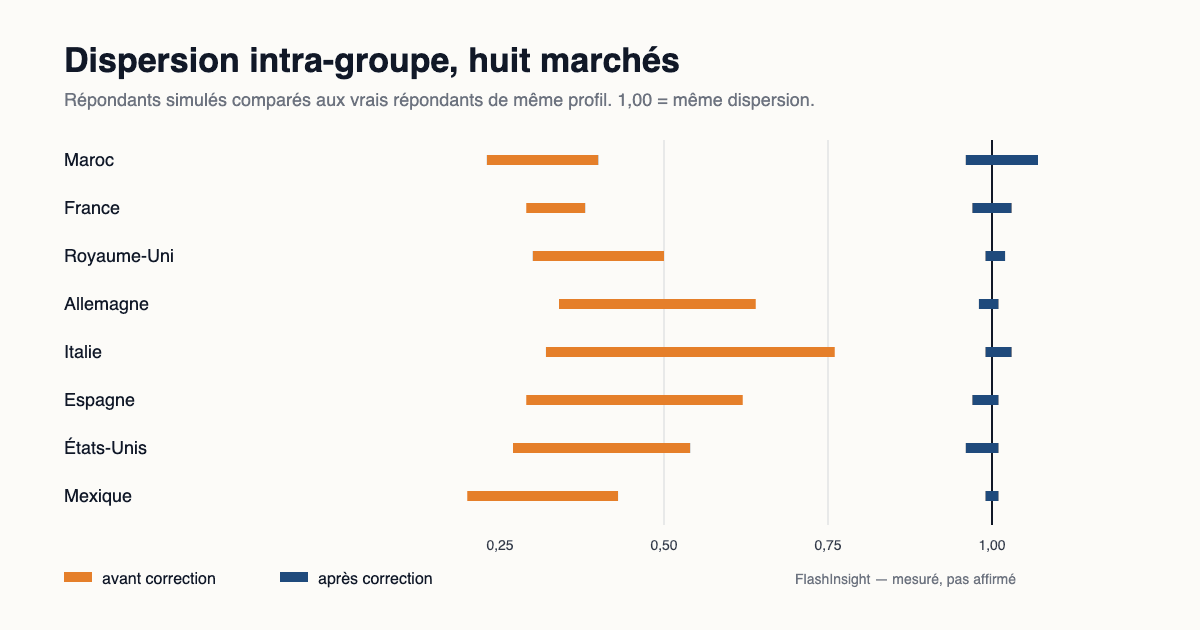
Avant correction, entre un cinquième et trois quarts de la dispersion humaine. Après, à quelques centièmes près, dans chaque marché. Le chiffre se lit comme un rapport : à 1,00, des répondants simulés de même profil sont en désaccord exactement autant que de vrais répondants de ce profil. En dessous, ils se ressemblent trop.
| Marché | Avant | Après |
|---|---|---|
| Maroc | 0,23 – 0,40 | 0,96 – 1,07 |
| France | 0,29 – 0,38 | 0,97 – 1,03 |
| Royaume-Uni | 0,30 – 0,50 | 0,99 – 1,02 |
| Allemagne | 0,34 – 0,64 | 0,98 – 1,01 |
| Italie | 0,32 – 0,76 | 0,99 – 1,03 |
| Espagne | 0,29 – 0,62 | 0,97 – 1,01 |
| États-Unis | 0,27 – 0,54 | 0,96 – 1,01 |
| Mexique | 0,20 – 0,43 | 0,99 – 1,01 |
Le Mexique était le pire des huit avant que nous regardions, à un cinquième de la dispersion humaine. Il est aujourd’hui parmi les plus proches. La couche de personnalité a été corrigée partout en une seule passe, et est passée de 0,52 – 0,99 à 0,85 – 1,00.
Un profil de calibration a été volontairement laissé tel quel : un ancien profil marocain, retiré des nouvelles études mais conservé pour que les travaux déjà livrés restent reproductibles à l’identique. Lui rendre sa dispersion changerait en silence des résultats qu’un client a déjà entre les mains.
Toutes les moyennes étaient déjà justes. C’est précisément pour cela que personne ne l’avait vu.
Face à quoi ces chiffres sont-ils mesurés ?
Face à des enquêtes nationales auprès de vraies personnes, jamais face à un modèle. Les cinq marchés européens sont mesurés face à la vague 11 de l’European Social Survey. Les États-Unis et le Mexique face au World Values Survey. Le Maroc face à une enquête nationale de 1 016 répondants réalisée par notre partenaire Insights House et pondérée sur les marges publiques. La personnalité face à Twin-2K-500, 2 058 répondants américains, la base publique qui nous sert aussi de contrôle.
Chaque correction a été vérifiée sur cinq répétitions de dix mille profils générés avant d’être mise en service. Nous ne publions pas la façon dont la correction fonctionne : c’est notre moteur. Nous publions ce face à quoi elle est mesurée et ce qu’elle mesure, c’est-à-dire ce dont un acheteur a besoin pour nous tenir à notre parole.
Qu’est-ce que cela ne prouve pas encore ?
C’est une calibration, pas une validation. Nous avons mis le moteur d’accord avec les enquêtes qui ont servi à le calibrer. Le banc hors échantillon, avec des questions nouvelles et sans seconde chance, est pré-enregistré et n’a pas encore été lancé. D’ici là, la formulation honnête est que la correction tient face à cette mesure, pas que le problème est réglé.
La référence a sa propre marge d’erreur. Sur le marché américain, nous l’avons mesurée : notre référence humaine est elle-même une estimation, à environ ±0,02 près. Quand le moteur reproduit la structure humaine à 0,004 près, il reproduit donc notre estimation à 0,004 près. La correction reste nette, nous partions de 0,168, mais 0,004 n’est pas une promesse de précision.
Un marché n’a pas de contrôle indépendant. Les États-Unis ont pu être vérifiés sur une seconde base, sans lien avec la première. Le Mexique repose sur une seule enquête.
Notre indice de fiabilité ne note toujours pas la dispersion. Nous l’avons écrit dans nos réponses aux 20 questions d’Esomar, et cela reste vrai : la génération est corrigée, l’indice ne la mesure pas, et nous ne publions donc aucun intervalle de confiance tiré de notre variance.
Que demander à un fournisseur de répondants synthétiques ?
- Face à quelle population chaque marché est calibré, avec le nom et la vague de l’enquête.
- Le rapport de dispersion, marché par marché, avant et après toute correction.
- Si les questions de test ont été vues pendant la calibration. Si oui, le chiffre décrit un ajustement, pas une prédiction.
- Quels marchés ont un second contrôle indépendant, et lesquels reposent sur une seule enquête.
- Ce que son indice de fiabilité note, et ce qu’il ne note pas.
- S’il accepte un test en parallèle, à l’aveugle, publié quel qu’en soit le résultat.
Le code international ICC/Esomar, révisé en 2025, oblige déjà à dire au client quand des données synthétiques ou des personas synthétiques sont utilisés, et avec quel niveau de supervision humaine. Le détail est dans notre fiche répondant synthétique.
Notre invitation reste ouverte. Toute organisation prête à mener un test de concept en parallèle, le sien sur un vrai terrain, le nôtre en synthétique, tous deux à l’aveugle jusqu’au bout, est la bienvenue. Nous partagerons le protocole et publierons le résultat, quel qu’il soit. La version anglaise de cette note est ici.
Questions fréquentes
Les répondants synthétiques sont-ils fiables ?
Assez pour classer et trier des idées tôt, pas encore assez pour remplacer le terrain. Leur défaut le plus courant ne se voit pas dans les moyennes : ils sont trop d’accord entre eux. Mesurée face aux enquêtes nationales de huit marchés, la dispersion de nos répondants simulés allait de 0,20 à 0,76 de la dispersion humaine avant correction, et de 0,85 à 1,07 après.
Quelle différence entre précision et fiabilité ?
Un chiffre de précision compare une moyenne simulée à une moyenne humaine, sur des questions dont on connaît déjà la réponse : c’est la partie facile. La fiabilité, pour comparer des options, dépend aussi de la dispersion : à quel point des répondants simulés de même profil sont encore en désaccord, comparé à de vraies personnes du même profil. Un panel peut être parfait sur le premier point et faux sur le second.
Qu’est-ce que la sous-dispersion ?
C’est quand des répondants simulés sont plus d’accord entre eux que de vraies personnes. On la lit comme un rapport : 1,00 veut dire autant de désaccord que chez les humains. En dessous, le désaccord qui existe sur le marché n’a jamais été recruté dans le panel. Toutes les moyennes restent justes, et la comparaison entre options est faussée.
Face à quoi ces chiffres sont-ils mesurés ?
La vague 11 de l’European Social Survey pour la France, le Royaume-Uni, l’Allemagne, l’Italie et l’Espagne. Le World Values Survey pour les États-Unis et le Mexique. Une enquête nationale de 1 016 répondants réalisée par Insights House pour le Maroc. Twin-2K-500, une base publique de 2 058 répondants américains, pour la personnalité. Chaque correction a été vérifiée sur cinq répétitions de dix mille profils générés.
Un panel synthétique peut-il remplacer un panel réel ?
Non. C’est une étape de pré-test entre l’intuition et le terrain : utile pour classer et trier tôt des concepts, des messages ou des stimuli, afin que moins d’idées, et de meilleures, partent sur le terrain. Ce n’est pas un substitut quand le résultat porte sur une opinion minoritaire, une catégorie vraiment nouvelle, ou une décision qui ne sera jamais vérifiée auprès de vraies personnes.
Que demander à un fournisseur de répondants synthétiques ?
Face à quelle population chaque marché est calibré, avec le nom et la vague de l’enquête. Le rapport de dispersion, marché par marché, avant et après correction. Si les questions de test ont été vues pendant la calibration : si oui, le chiffre décrit un ajustement, pas une prédiction. Et s’il accepte un test en parallèle, à l’aveugle, publié quel qu’en soit le résultat.
Method over Magic.