 Dr Laurent Florès
Personas synthétiques : pourquoi l’IA caricature les répondants (les données de Pew à l’appui)
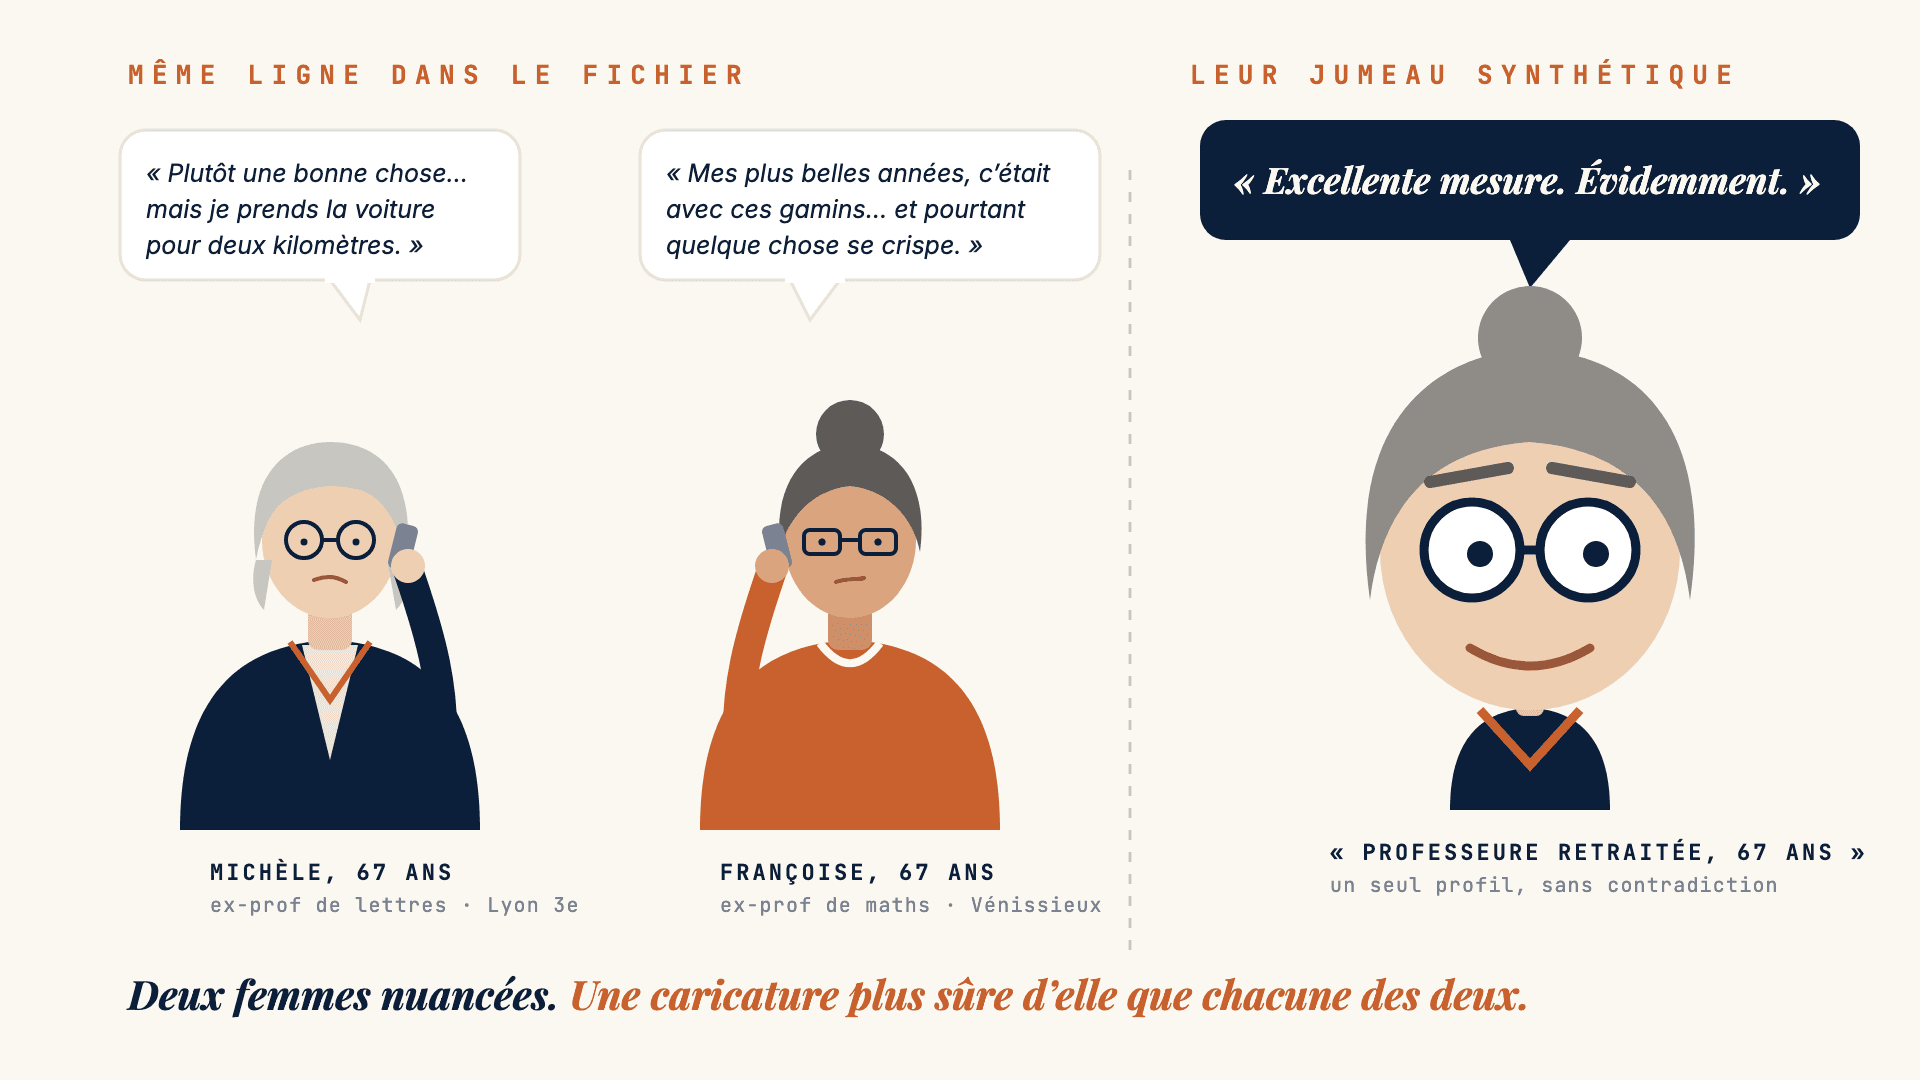
Michèle et Françoise ont le même profil, et pas les mêmes avis. Leur jumeau synthétique, lui, est plus tranché que chacune des deux. Mesuré sur les données publiées par Pew : des opinions poussées loin du centre, un désaccord réduit de près d’un tiers.
Deux femmes au profil identique ne sont pas d’accord entre elles, et chacune se contredit elle-même. Leur jumeau synthétique ne fait ni l’un ni l’autre — et il est plus tranché que chacune des deux. Ce n’est pas une anecdote. Sur les données publiées par Pew, c’est une pente de 1,26 et une dispersion de 0,71.
Deux professeures à la retraite
Michèle a 67 ans. Elle a enseigné les lettres pendant trente-cinq ans dans un lycée du 3e arrondissement de Lyon. Elle a voté à gauche toute sa vie. Bac+5, retraitée, une fille à Paris.
Françoise a 67 ans. Elle a enseigné les mathématiques pendant trente-trois ans dans un collège de Vénissieux. Elle a voté à gauche toute sa vie. Bac+5, retraitée, un fils à Lyon.
Dans n’importe quel fichier d’échantillonnage, c’est la même ligne. Même âge, même sexe, même région, même diplôme, même profession, même orientation politique. Construisez un persona synthétique à partir d’un profil : vous obtenez un seul profil pour les deux. C’est là que les ennuis commencent.
Ce qu’elles se disent au téléphone
— Tu as vu, ils reparlent d’interdire les vieilles voitures au centre.
— Franchement Michèle, à un moment ça suffit. La mienne a quinze ans et je n’ai pas les moyens d’en changer. Le climat, oui, bien sûr. Mais ce n’est pas moi le problème.
— Moi je trouve plutôt que c’est une bonne chose. Cela dit, je dis ça et je prends la voiture pour faire deux kilomètres, à cause de mes genoux. Donc je ne suis pas très crédible.
— Au moins tu le reconnais. Ce qui m’agace, ce sont ceux qui font la leçon à tout le monde et qui prennent l’avion quatre fois par an.
— Là-dessus on est d’accord. Et le quartier, tu trouves qu’il a changé ?
— Il a changé, oui. Pas forcément en mal.
— Je ne sais pas. Mes plus belles années d’enseignement, c’était avec des gamins qui venaient d’arriver d’ailleurs. Et en même temps je ne reconnais plus ma rue, et quelque chose en moi se crispe, et ça ne me plaît pas que ça se crispe.
Deux femmes identiques sur le papier. Sur le climat, l’une est inquiète et l’autre est inquiète d’autre chose. Sur l’immigration, l’une est claire et l’autre tient deux choses contradictoires sans les résoudre. Et chacune agit contre l’une de ses propres valeurs — Michèle prend sa voiture, Françoise se méfie d’institutions qu’elle a servies toute sa vie.
Rien de tout cela n’est remarquable. C’est la condition ordinaire d’une personne.
Remarquez aussi ce qui décide de la conversation : une voiture de quinze ans et une paire de genoux usés. Aucune de ces deux variables ne figure dans un fichier d’échantillonnage.
Ce que répond leur jumeau synthétique
Posez la même question à un répondant synthétique bâti sur ce profil, vous obtiendrez une réponse. Posez-la à un second, bâti sur le même profil, vous obtiendrez à peu près la même. Les deux seront cohérents, articulés, plausibles. Aucun des deux ne prendra sa voiture en se trouvant peu convaincant.
Et la réponse sera plus tranchée que celle de Michèle et plus tranchée que celle de Françoise. Pas au hasard — systématiquement.
Ce n’est pas une impression. Cela se mesure.
La caricature, mesurée
Fin septembre, le Pew Research Center a publié l’une des évaluations publiques les plus sérieuses à ce jour sur les répondants synthétiques : un jumeau numérique par panéliste réel, trois vagues de son panel probabiliste, près de 300 questions. Erreur moyenne : 12 points. Verdict : not really, pas vraiment. Nous en avons fait une lecture détaillée, en anglais.
Pew a raison, et l’étude est la meilleure preuve publique dont nous disposions. Mais le Center a fait quelque chose de plus utile encore : il a publié le détail, question par question, modalité par modalité. Ce qui veut dire que n’importe qui peut rouvrir les chiffres et leur poser une autre question que celle que Pew leur a posée.
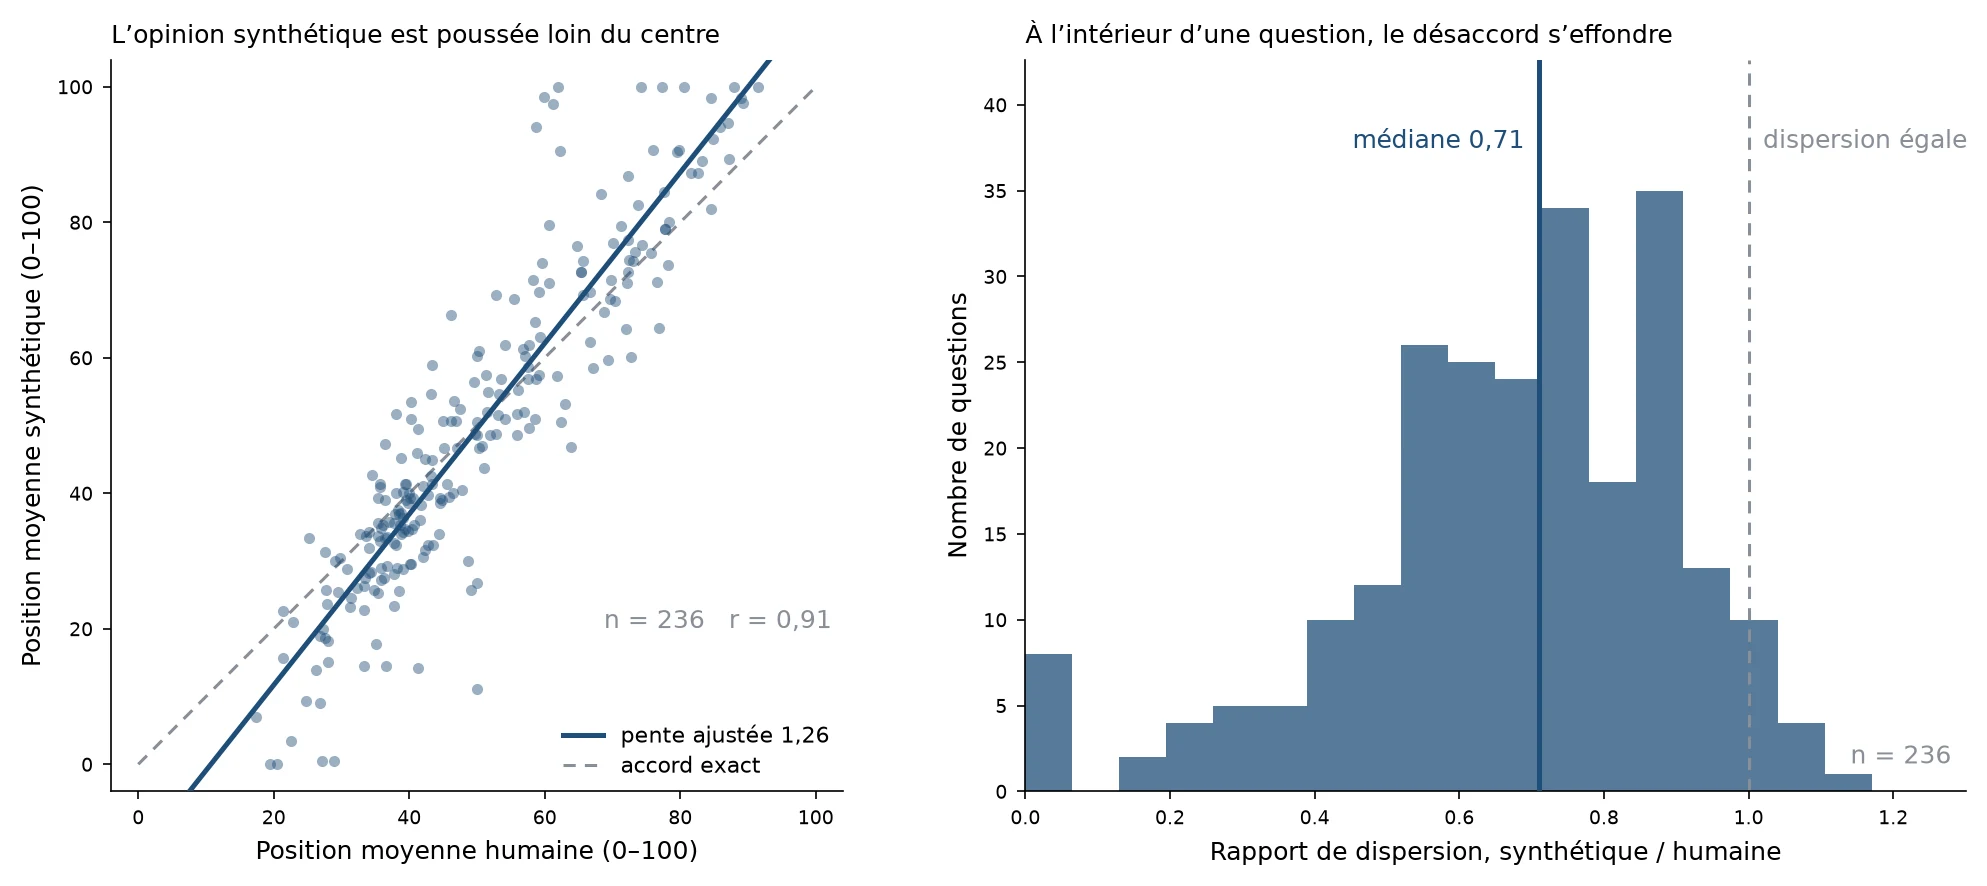
À gauche, chaque point est une question. Si les répondants synthétiques étaient justes, les points suivraient la diagonale. Ils suivent une droite plus raide : 1,26. Tout ce qui s’écarte du milieu de l’échelle est poussé plus loin encore, et le pivot de cette dilatation tombe à 51,8 sur 100 — le centre exact. L’écart moyen au centre passe de 14,4 points chez les humains à 19,6 chez les synthétiques. Dans 72 % des questions, l’opinion synthétique est plus tranchée que l’opinion réelle.
Mais la ressemblance tient : r = 0,91. Le modèle sait parfaitement de quel côté penche chaque question, et dans quel ordre se classent les sujets.
À droite, l’autre moitié. À l’intérieur de chaque question, le désaccord entre les personnes s’évapore : la dispersion tombe à 0,71de la valeur humaine, et elle est plus faible dans 97 % des questions. Michèle et Françoise se ressemblent davantage que Michèle et Françoise.
Exagérer ce qui distingue, effacer ce qui nuance. C’est la définition exacte d’une caricature — et c’est pourquoi on reconnaît quelqu’un au premier coup d’œil dans un dessin de presse, et pourquoi on ne peut pas s’en servir pour lui tailler un costume.
Les chiffres viennent d’un panel américain et les deux professeures sont lyonnaises : c’est précisément l’intérêt. Le mécanisme ne tient pas au pays, et les travaux cités plus bas le retrouvent sur trente pays européens, France comprise.
Il ne tient pas non plus à Pew. À Columbia, l’équipe qui a bâti l’un des plus grands bancs d’essai de jumeaux numériques a mesuré sa propre technologie : dans 154 mesures sur 164, les jumeaux sont moins dispersés que les humains qu’ils copient. Elle parle de funhouse mirrors, les miroirs déformants de la fête foraine. Même image, même diagnostic. Ce défaut a un nom, la sous-dispersion, et nous l’avions décrit dans une chronique du Journal du Net : quand des répondants sont unanimes, l’unanimité elle-même est un signal d’alerte.
Pourquoi le modèle fait cela
Parce que nous lui posons la mauvaise question, et qu’il répond très bien à celle-là.
Devant un profil et une question, il ne cherche pas ce que cette personne répondrait. Il ne la connaît pas, et personne ne la connaît à partir de six variables. Il cherche quel genre de personne c’est, et ce que ce genre-là répondrait. Il produit un archétype — et un archétype n’a pas de contradictions, puisqu’il est fait des traits qui le définissent.
Une professeure retraitée de gauche archétypale ne prend pas sa voiture en s’en voulant. Michèle, si.
Le modèle n’est pas sous-informé sur la personne. Il est trop sûr de ce que la personne implique.
C’est aussi pourquoi enrichir les profils ne règle rien, ce qui a surpris tout le monde, nous les premiers. Ajouter des variables ne donne pas au modèle une personne plus réelle ; cela lui donne davantage de traits sur lesquels se sur-engager. L’équipe de Columbia arrive au même constat : des jumeaux nourris de plus de 500 réponses personnelles ne font pas mieux que la seule démographie.
La même conclusion arrive par un autre chemin. Chuyao Wang (2026, arXiv 2609.16395), travaillant sur la vague 11 de l’European Social Survey dans 30 pays, montre que le seul ajout du nom du pays à une biographie de trois variables fait passer la corrélation médiane par item de −0,03 à 0,52 — tandis que des profils plus riches n’apportent aucun gain constant, et que la restitution au niveau individuel reste négligeable dans toutes les conditions. Le modèle répond avec des hypothèses de niveau national, pas avec des attitudes individuelles.
Ce que cela change quand on achète une étude
Une caricature est excellente pour deux choses et mauvaise pour une troisième, et la frontière est nette.
Elle est bonne pour reconnaître et pour comparer.Quel concept arrive en tête, quel message porte, quel segment est le plus réceptif, quel frein pèse plus qu’un autre. Sur les batteries du questionnaire de Pew — lequel de ces treize problèmes vous inquiète le plus, quel pays voyez-vous le plus favorablement — l’échantillon synthétique classe les items comme les humains, avec une corrélation médiane de 0,85 là où deux échantillons réels de même taille atteindraient 0,98. Pas parfait. Utilisable, et énoncé avec sa marge.
Elle est mauvaise pour mesurer.Un pourcentage issu d’un échantillon synthétique n’est pas un pourcentage : sur les questions à deux modalités du corpus Pew, l’écart moyen sur la part majoritaire est de 13 points. Une dispersion, une part d’extrêmes, un intervalle de confiance calculés là-dessus sont faux dans une direction connue d’avance.
Il existe une troisième catégorie où rien n’est récupérable : tout ce qui ne porte pas sur ce que les gens pensent mais sur ce qu’ils savent, ont remarqué, ou ignorent. Le modèle répond comme une population parfaitement informée — 98 % de bonnes réponses à une question de droit constitutionnel où le public réel plafonne à 52 %. Et le « ne sait pas » s’effondre de 18 % à 7 %. Michèle et Françoise ne savent pas tout.
Une habitude que notre métier devrait adopter
Une seule, et elle ne coûte rien : publier le plafond à côté du chiffre.
Une corrélation de 0,85 face à un plafond humain de 0,98, c’est une information : on sait ce à quoi on renonce. Une corrélation de 0,85 toute seule, c’est un argument de vente. La différence entre les deux est, me semble-t-il, ce que la profession est en droit d’exiger de ce marché — et ce qu’elle devrait exiger d’abord de ceux d’entre nous qui en vivent.
C’est ce que nous faisons pour la dispersion : nous la mesurons face aux enquêtes nationales de huit marchés, avant et après correction, et nous publions les chiffres.
Prendre les douze points de Pew et conclure « ça ne marche pas » est un contresens. Annoncer « 90 % de corrélation avec les humains » sans dire sur quelle quantité ni face à quel plafond est l’erreur symétrique, et de loin la plus répandue.
Le chiffre le plus repris par le marché en est l’exemple type : « 85 % des réponses humaines reproduites ». Il vient d’une étude sérieuse, et il ne dit pas ce qu’on lui fait dire. Je l’ai décortiqué dans ma chronique pour Market Research News, « Les personas synthétiques reproduisent 85 % des réponses humaines… Vraiment ? ».
Michèle et Françoise sont un portrait composé, mais vous les connaissez. Elles ne sont pas la même personne, et aucune des deux n’est la caricature qu’on ferait d’elle. On peut apprendre beaucoup d’un bon dessin — à condition de savoir que c’en est un.
Méthode et sources
Les chiffres attribués à Pew proviennent de son rapport et de son topline du 30 septembre 2026. Les chiffres de la figure proviennent d’une ré-analyse de ce même topline public, ré-extrait et vérifié ligne à ligne contre la source : 284 des 287 items identiques au topline brut, les trois restants étant des réparations manuelles documentées, qui ont été reproduites indépendamment.
La figure porte sur les 236 questions dotées d’une échelle ordonnée d’au moins trois points ; la position moyenne est calculée sur les modalités substantielles de l’échelle, hors « sans réponse » et hors modalités hors-échelle du type « ne sait pas », placées sur un support régulier 0–100. L’ordre des modalités a été vérifié item par item : dix-huit jeux de modalités du topline placent la catégorie médiane en dernière colonne, là où une moyenne calculée sur l’ordre des colonnes serait fausse.
Une note technique, puisqu’une pente supérieure à 1 y invite : l’erreur de mesure sur l’axe horizontal atténue une pente, elle ne la gonfle pas. Ici les positions humaines sont des moyennes sur 3 400 à 6 700 répondants, l’atténuation est donc négligeable — et si elle jouait, 1,26 serait une sous-estimation.
L’analyse est exploratoire et n’a pas été pré-enregistrée. Elle décrit un modèle sur un corpus : Pew montre dans son propre chapitre de comparaison de modèles qu’un autre modèle rend le public plusextrême que la réalité là où celui-ci le rend plus centriste. La compression de la variance n’est pas une loi de la nature ; c’est une propriété à réétablir à chaque changement de modèle.
- Chapekis, Lau, Bestvater, Shah, Mercer & Smith (2026). Can AI Stand In for Human Survey-Takers? Not Really. Pew Research Center, 30 septembre 2026. pewresearch.org
- Comparison of human and AI-generated survey results— topline comparatif, 56 pages, source de tous les chiffres ré-analysés ici. pewresearch.org (PDF)
- Wang, C. (2026). Silicon sampling answers with country-level assumptions, not individual attitudes: Cross-national evidence from the European Social Survey. arxiv.org/abs/2609.16395
- Peng, T., Gui, G., Brucks, M., Toubia, O. et al. (2026). Digital Twins as Funhouse Mirrors: Five Key Distortions. Science Advances. arxiv.org/abs/2509.19088
Questions fréquentes
Les personas synthétiques sont-ils fiables ?
Pour comparer, oui en partie : sur les données publiées par Pew, ils retrouvent de quel côté penche une question et dans quel ordre se classent des options. Pour mesurer, non : leurs pourcentages s’écartent en moyenne de 12 points, leurs opinions sont trop tranchées et le désaccord entre les gens est réduit à 0,71 de sa valeur réelle.
Pourquoi l’IA caricature-t-elle les répondants ?
Parce qu’à partir de quelques variables, le modèle ne simule pas une personne : il répond comme l’archétype de son profil. Un archétype n’a pas de contradictions. Il exagère donc ce qui distingue les groupes et efface ce qui nuance les individus.
Que montre l’étude de Pew sur les répondants synthétiques ?
Pew a fait répondre un jumeau numérique de chaque panéliste à près de 300 questions de son panel. L’écart moyen avec les vraies réponses est de 12 points, et Pew conclut que l’IA ne peut pas remplacer un sondage. Les données publiées permettent aussi de mesurer la caricature : pente de 1,26, dispersion de 0,71.
Quand peut-on utiliser un échantillon synthétique ?
Pour explorer, comparer et classer : quel concept arrive en tête, quel message porte, quel frein pèse le plus. Pas pour annoncer un pourcentage, une part d’extrêmes ou un niveau de notoriété, ni pour une décision qui dépend d’un seuil.